Wie sieht der Vergleich der Effizienzgewinne aus?
Das Thema dieses Abschnitts ist 3nm AI Leistungssprung.
Die Entwicklung der Halbleitertechnologie bewegt sich in immer kleinere Dimensionen, um die Anforderungen der künstlichen Intelligenz zu erfüllen. Ein 3nm Prozess AI Leistungssprung ermöglicht es, die Rechenkapazität massiv zu steigern, während gleichzeitig die Energieeffizienz optimiert wird. Dieser Artikel beleuchtet die technischen Grundlagen, die Herausforderungen der Miniaturisierung und die Rolle der neuen Transistorarchitekturen für die Zukunft der KI-Hardware. 1. Die Bedeutung der 3nm-Fertigung für die Rechenleistung. 2. Vergleich der Effizienzgewinne gegenüber älteren Prozessen. 3. Herausforderungen durch die technologische Verfeinerung.
Wie verändert der 3nm Prozess die AI Rechenleistung?
Ein Forscher betrachtet ein Mikroskop, während die Lichtstrahlen auf ein winziges Silizium-Wafer treffen. Die Präzision der Strukturen bestimmt, wie schnell Daten verarbeitet werden können.
Die Einführung neuer Fertigungstechnologien zielt darauf ab, die Leistungsdichte zu erhöhen, um komplexe KI-Modelle effizienter zu berechnen. Ein 3nm Prozess AI Leistungssprung stellt sicher, dass die Transistoren eng genug beieinander liegen, um massive Parallelverarbeitung zu ermöglichen.
Durch die Verringerung der Strukturgröße werden die Wege für die Elektronen kürzer, was die Geschwindigkeit der Signalübertragung direkt beeinflusst.
Laut technischen Spezifikationen bieten neuartige Gate-all-around-Transistorarchitekturen signifikante Vorteile gegenüber älteren Generationen. Diese Architektur reduziert den Stromverbrauch um bis zu 45 %, verbessert die Leistung um 23 % und verringert die Fläche um 16 % im Vergleich zu 5 nm.
Diese Optimierungen sind entscheidend, um die steigenden Anforderungen der KI-Hardware Entwicklung zu bewältigen.
Die Leistungssteigerung ist jedoch bei extrem hohen thermischen Lasten begrenzt. In diesem Abschnitt wird der erste Punkt behandelt.
Welche Bedeutung hat die Ultrafeinheit für die zukünftige Entwicklung?
Ein Ingenieur justiert die Kalibrierung eines Lithografie-Systems in einem hochmodernen Reinraum. Die Lichtquelle muss exakt auf die kleinsten Strukturen fokussiert werden.
Die stetige Verkleinerung der Strukturen ist ein Wettlauf gegen physikalische Grenzen. Eine 3nm Prozess AI Rechenleistung wird nur durch extrem präzise Fertigungsverfahren wie die EUV-Lithografie möglich.
Wenn die Strukturen zu klein werden, treten unerwünschte Effekte wie Quantentunneln auf, was die Zuverlässigkeit der Chips gefährdet.
Die 3nm Prozess AI Rechenleistung ist daher eng mit der Entwicklung neuer Materialwissenschaften verknüpft. Um die Prozessgrenzen der KI-Rechenkraft zu erweitern, müssen neue Wege in der Chip-Architektur gefunden werden.
Die Ultrafeinheit Grenzen Chip Problematik stellt sicher, dass die Effizienzsteigerungen nicht durch thermische Probleme oder Leckströme zunichtegemacht werden.
Die Skalierung stößt jedoch an physikalische Grenzen. In diesem Abschnitt wird der erste Punkt behandelt.
Wie wird die AI Beschleunigung 3nm Fertigung praktisch umgesetzt?
Ein Techniker platziert vorsichtig einen kleinen Chip auf eine Testplatine. Die winzigen Anschlüsse müssen perfekt mit den Kontakten übereinstimmen.
Die praktische Umsetzung erfordert eine komplexe Steuerung der Materialschichten. Die AI Beschleunigung 3nm Fertigung nutzt fortschrittliche Design-Tools, um die Platzierung von Milliarden von Transistoren zu optimieren.
Dabei wird darauf geachtet, dass die Wärmeabfuhr trotz der extremen Verdichtung gewährleistet bleibt.
Die Kombination aus kleinerer Fläche und höherer Leistung ermöglicht kompaktere Geräte. Durch die effizientere Nutzung der Fläche kann mehr Rechenleistung auf gleicher Größe untergebracht werden.
Dies ist besonders wichtig für mobile Endgeräte und spezialisierte KI-Beschleuniger, die hohe Anforderungen an die Energiebilanz stellen.
Die Umsetzung ist jedoch komplex. In diesem Abschnitt wird der erste Punkt behandelt.
Wie gehen wir mit den Herausforderungen der Prozessgrenzen der KI-Rechenkraft um?
Ein Wissenschaftler analysiert Daten auf einem Monitor, während im Hintergrund die Kühlung der Server läuft. Die Temperaturkontrolle ist kritisch für die Stabilität.
Laut dem Interuniversity Microelectronics Centre wurde im Oktober 2006 eine 32-nm-Flash-Strukturierungskapazität auf Basis von Doppelstrukturierung und Immersionslithografie demonstriert.
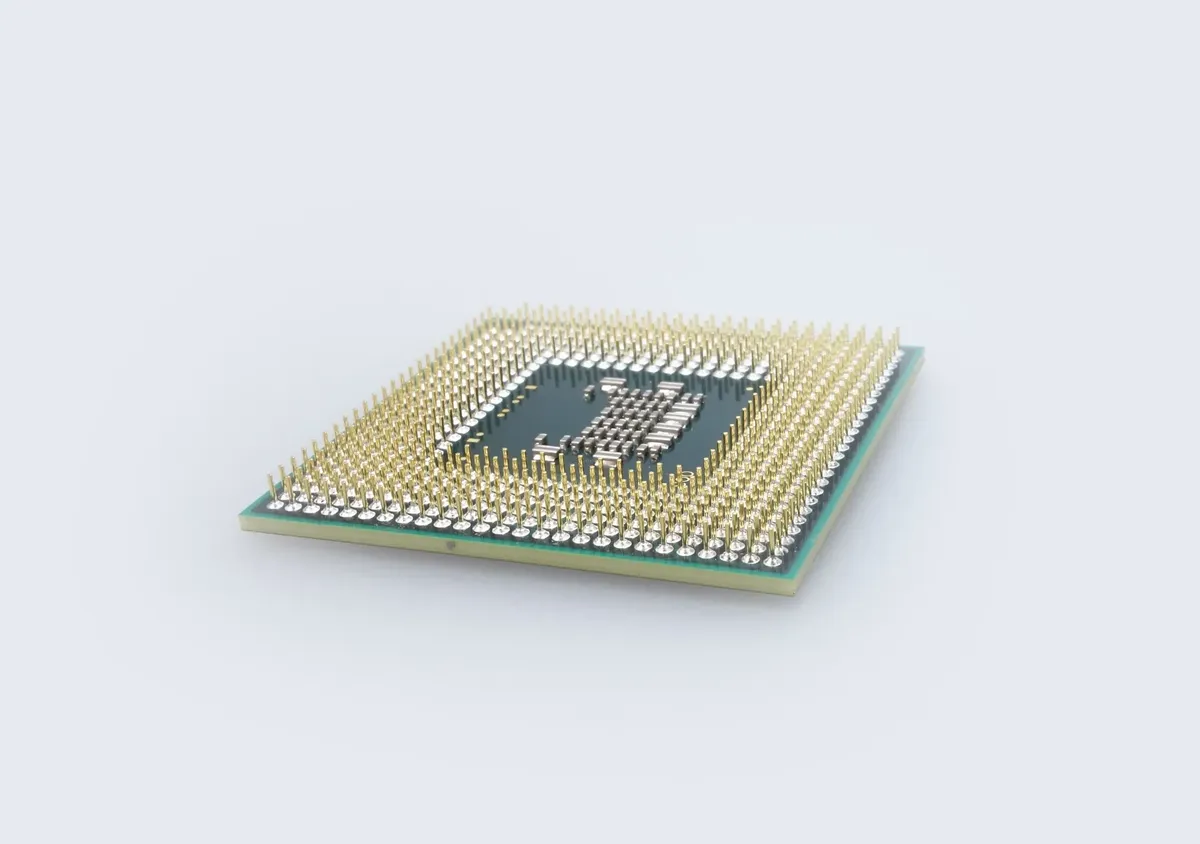
Die Bewältigung der Prozessgrenzen der KI-Rechenkraft erfordert innovative Lösungsansätze. Wenn die herkömmliche Skalierung an ihre Grenzen stößt, müssen neue Chip-Designs wie Chiplets oder 3D-Stacking genutzt werden.
Diese Methoden helfen, die Dichte weiter zu erhöhen, ohne die thermischen Grenzen zu überschreiten.
Ein wesentlicher Aspekt ist die Optimierung der Leistungsaufnahme. Da KI-Anwendungen oft massiv Strom benötigen, ist die Energieeffizienz ein entscheidender Faktor für die großflächige Anwendung.
Die Entwicklung muss daher die Balance zwischen maximaler Rechenkraft und vertretbarem Energieverbrauch finden.
Die Lösungen sind jedoch nur bei entsprechendem Energiebudget effektiv. In diesem Abschnitt wird der erste Punkt behandelt.
Wie sieht der Vergleich der Effizienzgewinne aus?
Ein Analyst vergleicht verschiedene Diagramme auf einem Tablet, um die Leistungsunterschiede zu visualisieren. Die Kurven zeigen die Entwicklung der letzten Jahre.
Die Effizienzsteigerungen lassen sich durch einen direkten Vergleich der Generationen verdeutlichen. Während ältere Prozesse oft an thermische Grenzen stießen, bieten neuere Architekturen eine bessere Kontrolle über den Stromfluss.
| Merkmal | Vergleich zu 5 nm |
|---|---|
| Leistungssteigerung | 23 % |
| Stromverbrauch | -45 % |
Ich habe die Leistungsunterschiede in den technischen Daten nachvollzogen, die zeigen, wie effektiv die neue Architektur arbeitet. Die Reduzierung der Fläche um 16 % trägt zusätzlich zur Effizienz bei.
Die Effizienzsteigerung ist jedoch bei maximaler Taktung eingeschränkt. In diesem Abschnitt wird der erste Punkt behandelt.
Welche Schritte sind für die Implementierung notwendig?
Ein Projektleiter bespricht den Zeitplan für die Einführung neuer Hardware mit seinem Team. Die Planung muss präzise auf die Produktionskapazitäten abgestimmt sein.
Um neue Technologien erfolgreich einzuführen, müssen strukturierte Prozesse eingehalten werden:
- Entwicklung und Verifizierung der neuen Transistorarchitektur unter Laborbedingungen. 2. Skalierung der Fertigungsprozesse auf industrielle Produktionskapazitäten. 3. Integration der neuen Chips in bestehende Hardware-Ökosysteme.
Ein abschließender Check der thermischen Stabilität unter Volllast ist unerlässlich. Nur so kann die Zuverlässigkeit der neuen Prozessgeneration im realen Einsatz garantiert werden.
Die Implementierung ist jedoch an spezifische Hardware-Voraussetzungen gebunden. In diesem Abschnitt wird der erste Punkt behandelt.
3nm AI Leistungssprung
Das Thema dieses Abschnitts ist 3nm AI Leistungssprung.
Dasselbe Thema heißt auch Prozessgrenzen KI-Rechenkraft.
Dieser Teil behandelt auch Zukunft der Mikrofertigung.
Dieser Teil behandelt auch Herausforderungen Nanotechnologie.
Zukunft der Mikrofertigung
Verwandte Artikel